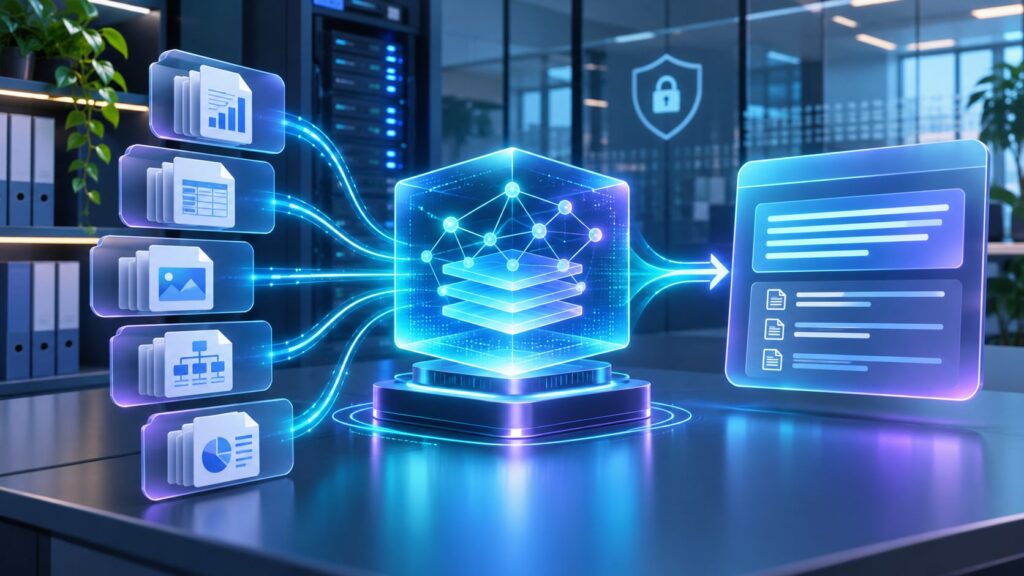
Une intelligence artificielle généraliste peut rédiger rapidement mais elle ne connaît pas spontanément les procédures, offres et documents internes d’une entreprise. Le RAG en entreprise répond à ce besoin en recherchant les passages pertinents dans une base documentaire avant de générer une réponse. L’IA s’appuie alors sur un contexte sélectionné au moment de la question au lieu de compter uniquement sur les connaissances apprises pendant son entraînement.
Cette approche peut alimenter un assistant pour les équipes, un outil de support ou une recherche conversationnelle. Elle n’est cependant pas magique. La qualité dépend surtout des documents, des droits d’accès, de la recherche et des tests. Un projet raisonnable commence par un périmètre précis plutôt que par l’indexation de tous les fichiers de l’entreprise.
Comprendre le fonctionnement du RAG
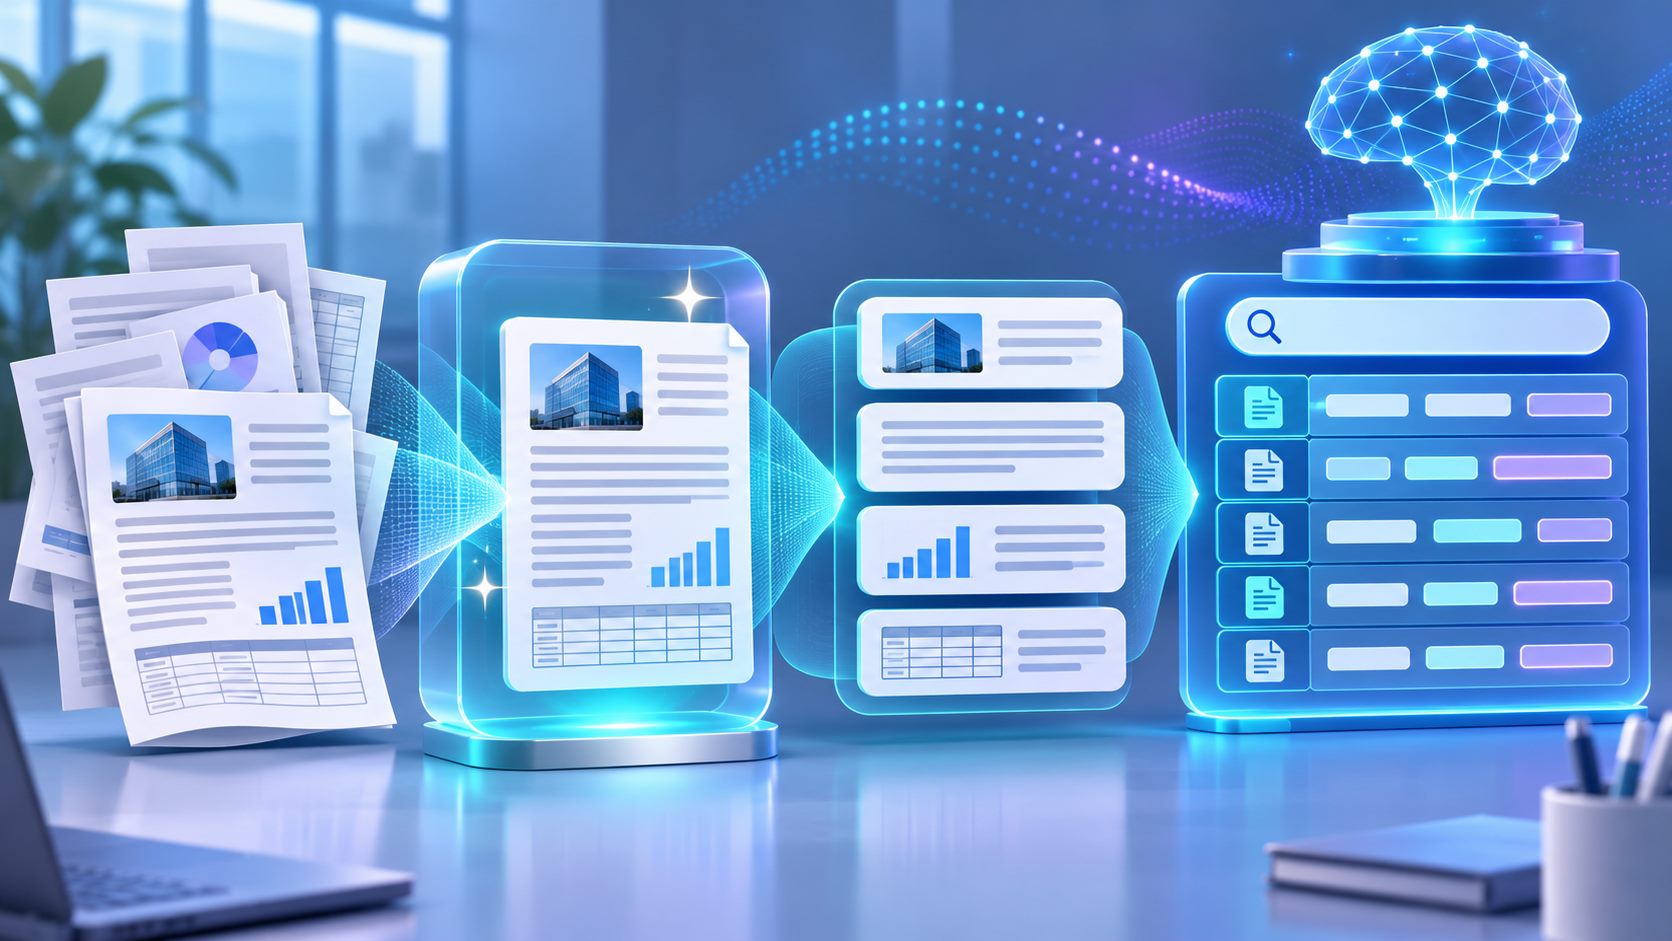
RAG signifie génération augmentée par récupération. Lorsqu’un utilisateur pose une question, le système transforme la demande en requête, cherche des extraits utiles puis les transmet au modèle avec des instructions. Le modèle rédige ensuite une réponse ancrée dans ces éléments et peut afficher leurs sources.
- L’ingestion collecte les fichiers et leurs métadonnées.
- Le découpage sépare les documents en passages cohérents.
- L’indexation rend ces passages interrogeables par mots-clés ou sens.
- La récupération sélectionne les éléments proches de la question.
- La génération formule une réponse à partir du contexte retrouvé.
Le système ne modifie pas le modèle à chaque mise à jour documentaire. Ajouter une nouvelle procédure ou remplacer une grille tarifaire peut suffire pour que les prochaines réponses s’appuient sur la version indexée. Cette souplesse explique l’intérêt du RAG pour les informations privées ou fréquemment actualisées.
Distinguer le RAG des autres méthodes
| Approche | Usage principal | Limite à surveiller |
|---|---|---|
| Prompt enrichi | Donner quelques informations à une demande ponctuelle | Contexte limité et saisie manuelle |
| RAG | Retrouver des faits dans une documentation évolutive | Dépend de la qualité de la recherche |
| Réglage fin | Adapter un comportement ou un style récurrent | Ne constitue pas une base de connaissances fiable |
| Recherche classique | Afficher une liste de documents ou de pages | L’utilisateur doit lire et synthétiser les résultats |
Le RAG est particulièrement adapté aux FAQ internes, modes opératoires, fiches produits, politiques RH et bases de support. Il est moins pertinent pour une analyse juridique autonome, une comparaison exhaustive de longs contrats ou une décision exigeant un raisonnement expert et une validation humaine.
Préparer une base documentaire réellement exploitable
Avant de choisir un outil, organisez les connaissances. Une base de connaissances interne structurée réduit les doublons et clarifie qui est responsable de chaque information. Sans ce travail, le système peut retrouver deux procédures contradictoires et produire une réponse ambiguë.
- Retirer les versions obsolètes et identifier le document de référence.
- Ajouter un titre, une date, un propriétaire et un niveau de confidentialité.
- Transformer les scans illisibles en texte exploitable.
- Conserver les tableaux avec leurs titres et unités.
- Créer une règle d’archivage et une fréquence de révision.
Le découpage mérite une attention particulière. Un passage trop court perd le contexte tandis qu’un bloc trop long dilue l’information. Les titres, sous-titres et paragraphes doivent guider la séparation. Un léger chevauchement entre deux segments peut éviter qu’une explication soit coupée au mauvais endroit.
Choisir une recherche adaptée aux questions
La recherche lexicale retrouve les mots exacts. La recherche vectorielle rapproche des formulations de sens similaire. Une méthode hybride combine les deux puis reclasse les résultats. Pour une PME, la meilleure option n’est pas forcément la plus complexe : elle est celle qui retrouve régulièrement le bon passage sur un jeu de questions représentatif.
Construisez un petit jeu d’évaluation avec des questions simples, ambiguës et impossibles. Notez le document attendu et la réponse correcte. Vérifiez ensuite si le bon extrait apparaît parmi les premiers résultats. Une réponse élégante ne compense jamais une récupération incorrecte.
Préserver les droits et les informations sensibles
Un assistant ne doit pas révéler un document qu’un utilisateur ne peut pas ouvrir directement. Les droits doivent donc être vérifiés au niveau de la récupération et non seulement dans l’interface. Séparez les espaces documentaires sensibles, journalisez les consultations et évitez d’envoyer des données confidentielles vers un service non validé.
Traitez également les documents récupérés comme des entrées non fiables. Un fichier peut contenir une instruction cachée ou une formulation qui tente de détourner le comportement du modèle. Des règles système, des filtres et des limites de sources réduisent ce risque sans l’annuler.
Mesurer la qualité avant le retour financier
Un projet pilote doit d’abord prouver que les réponses sont trouvables, exactes et sourcées. Mesurez le taux de récupération du bon passage, la part de réponses appuyées par une citation, le nombre de refus corrects et le temps gagné sur une tâche précise.
Reliez ensuite ces résultats aux coûts grâce à une méthode de mesure du ROI d’un projet IA. Prenez en compte l’hébergement, l’indexation, les appels au modèle, la maintenance documentaire, les tests et le temps de contrôle humain. Un assistant impressionnant mais peu utilisé n’apporte pas de valeur durable.
Lancer un pilote RAG à faible risque
- Choisir une équipe et un cas d’usage répétitif avec des réponses vérifiables.
- Limiter le corpus à quelques dizaines de documents à jour.
- Définir les utilisateurs autorisés et les données interdites.
- Préparer vingt à cinquante questions de test avec leurs sources attendues.
- Comparer les réponses à la méthode actuelle pendant plusieurs semaines.
- Corriger les documents et la recherche avant d’élargir le périmètre.
La documentation Microsoft explique que la génération augmentée par récupération combine recherche et modèle de langage afin d’ancrer les réponses dans les données. Elle rappelle aussi les enjeux de contrôle d’accès, de coût, de latence et de résistance aux contenus malveillants.
Éviter les erreurs qui dégradent rapidement le système
Indexer tout un espace partagé sans tri multiplie les contradictions. Utiliser uniquement une démonstration agréable masque les questions difficiles. Ne pas conserver les sources empêche l’utilisateur de vérifier. Enfin, laisser le projet sans responsable documentaire entraîne une baisse progressive de qualité.
Prévoyez un retour simple sur chaque réponse : utile, incomplète ou incorrecte. Analysez les échecs en séparant trois causes. Le document peut être absent, le bon passage peut ne pas avoir été retrouvé ou le modèle peut avoir mal exploité le contexte. Chaque problème demande une correction différente.
Construire une architecture proportionnée
Un pilote peut reposer sur un connecteur documentaire, un index géré et un modèle disponible dans l’environnement de l’entreprise. À plus grande échelle, il faut surveiller les synchronisations, la suppression effective des documents, la traçabilité, la disponibilité et le coût par question.
Le choix entre solution intégrée et architecture personnalisée dépend des exigences. Une solution intégrée accélère le démarrage. Une architecture sur mesure offre davantage de contrôle mais demande des compétences et une maintenance continues. Le bon niveau est celui que l’entreprise peut réellement exploiter et auditer.
Conclusion
Le RAG en entreprise permet de connecter une IA aux documents internes sans réentraîner constamment un modèle. Sa réussite repose moins sur l’effet de nouveauté que sur la qualité des sources, la recherche, les droits et l’évaluation. Commencez avec un corpus réduit, des questions vérifiables et un responsable clairement identifié. Élargissez seulement lorsque les réponses sont fiables et utiles dans le travail quotidien.
Questions fréquentes
Le RAG empêche-t-il toutes les hallucinations
Non. Il réduit le risque en fournissant un contexte pertinent mais le modèle peut encore interpréter un passage de manière incorrecte. Les citations, les tests et la possibilité de refuser une réponse restent indispensables.
Faut-il une base vectorielle pour commencer
Pas toujours. Une recherche lexicale ou hybride peut suffire pour un corpus réduit avec des termes précis. Le choix doit être validé par des questions réelles plutôt que par une préférence technique.
Combien de documents faut-il pour un pilote
Quelques dizaines de documents bien entretenus peuvent déjà démontrer la valeur. Un corpus limité facilite la vérification des réponses et la correction des erreurs avant une extension à d’autres équipes.