Le taggage côté serveur est souvent présenté comme une solution capable d’améliorer simultanément la mesure, les performances et le contrôle des données. Cette promesse mérite d’être précisée. Le dispositif ajoute un intermédiaire entre le navigateur et les plateformes de destination. Il offre davantage de maîtrise, mais il ne corrige ni un plan de mesure imprécis ni une gestion du consentement défaillante.
Avant de déployer un taggage côté serveur, une entreprise doit comprendre le flux, les coûts et les responsabilités. Pour beaucoup d’équipes, un pilote limité à quelques événements apporte davantage de valeur qu’une migration générale menée sans protocole de contrôle.
Comprendre le fonctionnement sans jargon
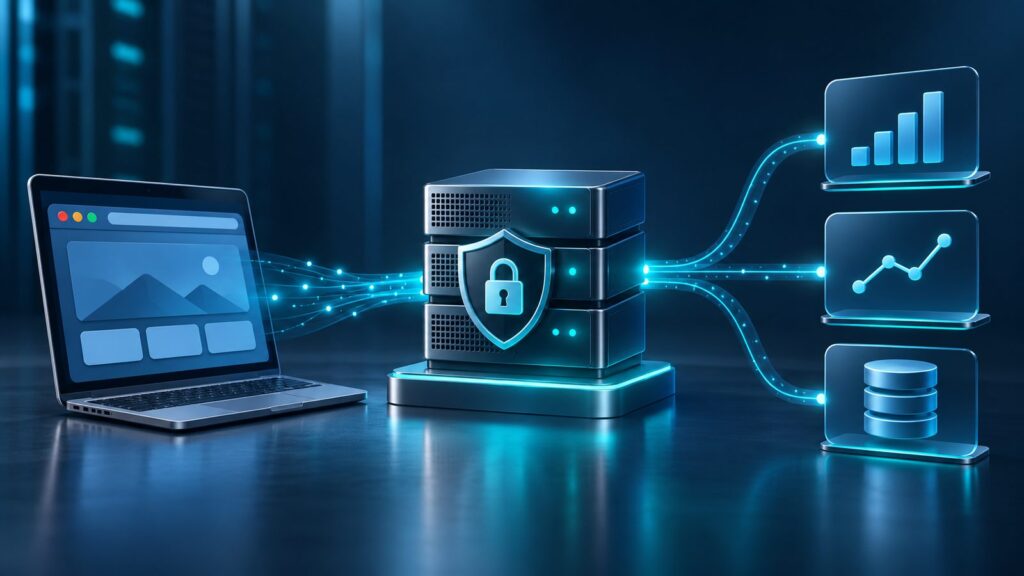
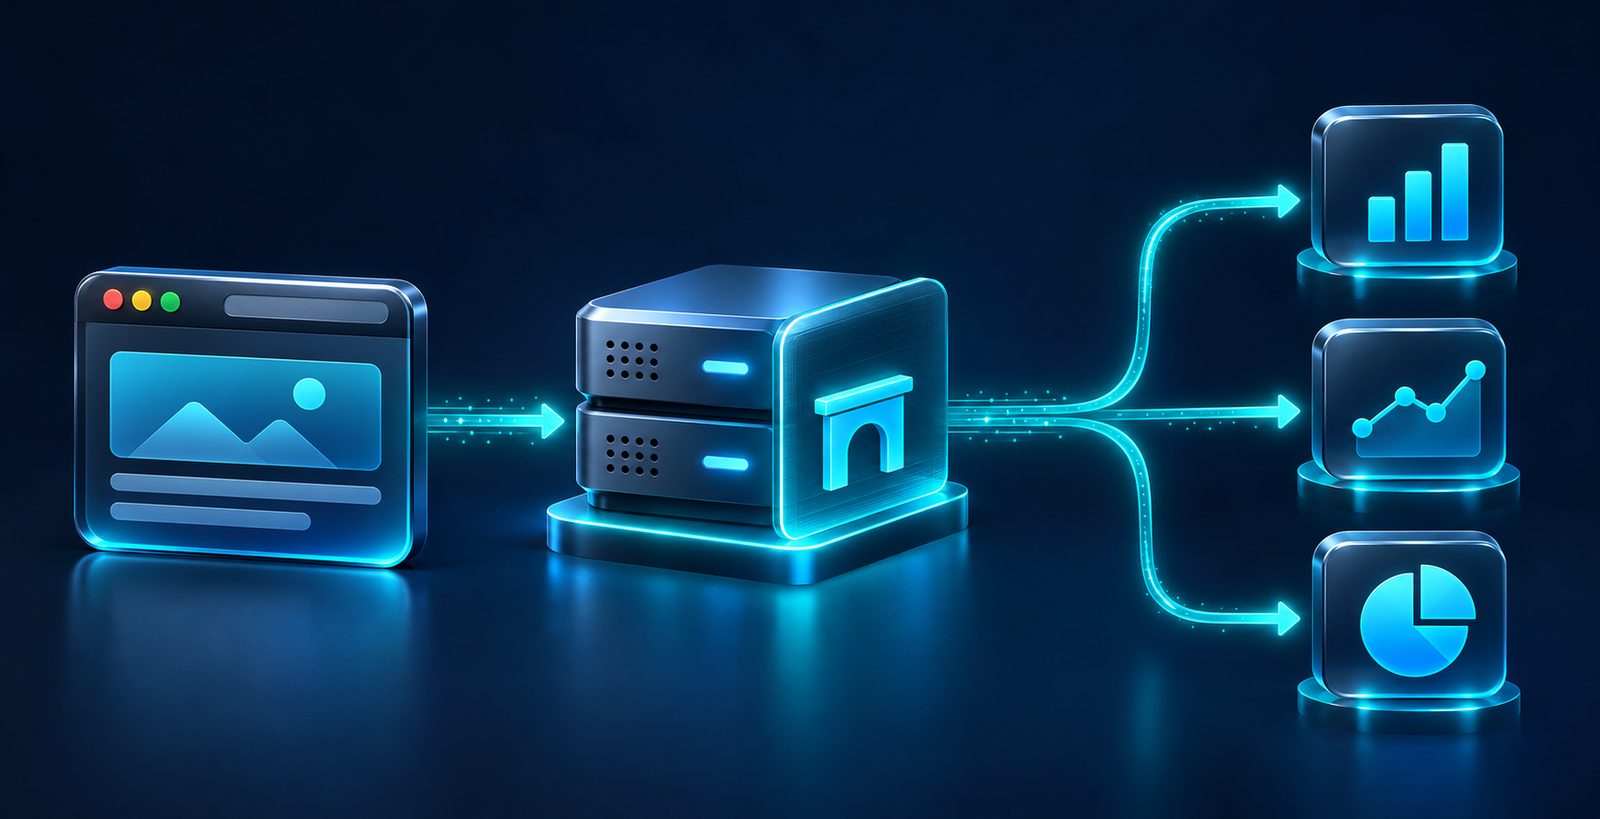
Dans un schéma classique, le navigateur envoie directement des requêtes vers plusieurs outils analytics ou publicitaires. Avec un conteneur serveur, le navigateur transmet d’abord les données à un point de collecte contrôlé par l’entreprise. Ce serveur reçoit l’événement, le transforme si nécessaire puis l’achemine vers les destinations autorisées.
Le navigateur reste présent dans la collecte. Les clics, formulaires et pages vues doivent toujours être détectés. Le serveur ne devine pas les actions de l’utilisateur. Il traite ce qui lui est envoyé et applique les règles définies.
- le conteneur Web collecte l’action et prépare la requête ;
- le domaine de collecte reçoit la requête ;
- un client serveur interprète le format entrant ;
- les règles filtrent enrichissent ou suppriment des paramètres ;
- les balises serveur envoient les données vers les destinations prévues.
La qualité du dispositif dépend donc du schéma de nommage et des paramètres transmis. Commencez par consolider votre plan de marquage analytics et ses règles de recette. Le serveur ne doit être ajouté qu’après avoir défini les décisions que la mesure doit soutenir.
Les bénéfices que l’on peut raisonnablement attendre
Le serveur permet de centraliser le routage. Une équipe peut supprimer des paramètres inutiles, uniformiser certains champs et empêcher une destination de recevoir des données qu’elle n’utilise pas. Elle dispose aussi d’un point d’observation commun pour diagnostiquer les erreurs.
Le déplacement d’une partie du traitement hors du navigateur peut réduire certaines requêtes exécutées côté client. L’effet sur les performances dépend cependant de l’architecture existante. Ajouter un conteneur serveur sans retirer de scripts ne rend pas automatiquement le site plus rapide.
Comparer taggage client et taggage serveur
| Critère | Côté client | Côté serveur | Point de vigilance |
|---|---|---|---|
| Exécution | Dans le navigateur | Dans un environnement serveur | Le navigateur reste nécessaire pour de nombreux événements |
| Routage | Vers chaque plateforme | Via un point contrôlé | Les destinations doivent rester documentées |
| Transformation | Limitée ou dispersée | Centralisée | Une règle erronée affecte plusieurs flux |
| Maintenance | Plus simple au départ | Infrastructure supplémentaire | Coût disponibilité et surveillance |
| Contrôle | Dépend des scripts chargés | Filtrage avant envoi | Le consentement reste obligatoire |
Ne pas confondre contrôle et conformité automatique
Un serveur contrôlé par l’entreprise offre des possibilités de filtrage, mais il ne rend pas la collecte conforme par nature. Les finalités, la base légale, la durée de conservation et les destinataires doivent toujours être définis. Les choix de consentement doivent être transmis et respectés dans les règles de déclenchement.
Le fait d’utiliser un sous-domaine propriétaire ne transforme pas automatiquement toutes les données en données internes. Dès qu’une information est envoyée vers une plateforme tierce, cette destination doit être prise en compte dans la gouvernance.
Évaluer les prérequis techniques
Le projet nécessite un environnement d’hébergement, un domaine de collecte, des certificats, une supervision et une procédure de déploiement. Il faut suivre les erreurs, la latence, la capacité et les coûts. Une panne ne doit pas supprimer silencieusement des événements importants.
- désigner un propriétaire du conteneur serveur ;
- séparer les environnements de test et de production ;
- versionner chaque changement ;
- surveiller le volume d’événements et les réponses des destinations ;
- prévoir une marche arrière documentée.
Le projet doit aussi s’appuyer sur une stratégie de données first party structurée et compréhensible. Collecter davantage n’est pas un objectif. Il faut améliorer la fiabilité des données utiles et réduire les transferts non nécessaires.
Définir un pilote limité
Choisissez un parcours représentatif mais non critique : consultation d’une page, soumission d’un formulaire de test et conversion secondaire. Documentez le flux actuel, les paramètres attendus et les volumes habituels. Implémentez ensuite la nouvelle route en parallèle dans un environnement de test.
La comparaison doit porter sur la présence des événements, les doublons, les valeurs des paramètres, les délais et les erreurs. Contrôlez aussi que les préférences de consentement produisent le résultat attendu. Un gain apparent de volume n’est pas nécessairement une amélioration : il peut révéler des événements dupliqués.
Mesurer les coûts et les bénéfices
Le coût comprend l’hébergement, le trafic, la maintenance, les tests et le temps d’expertise. Il augmente avec le volume et les exigences de redondance. Les bénéfices peuvent prendre la forme d’une meilleure qualité de données, d’un contrôle plus fin, d’une baisse de scripts clients ou d’un diagnostic plus rapide.
Définissez avant le pilote les critères qui justifieront la poursuite. Par exemple : réduction mesurable des requêtes côté navigateur, baisse des événements invalides, délai de diagnostic plus court ou suppression de paramètres inutiles avant transfert.
Mesurez également la latence entre la réception et l’envoi, le taux de réponses en erreur et les écarts de volume par rapport au système de référence. Une variation doit pouvoir être expliquée. Si le nouveau flux compte davantage de conversions, contrôlez d’abord les doublons, les nouvelles règles de session et les événements renvoyés après une tentative échouée.
Organiser la gouvernance des changements
Un conteneur serveur concentre des règles qui peuvent affecter plusieurs destinations. Les droits de modification doivent donc être limités, les versions nommées et les validations séparées de la création. Chaque changement devrait préciser son objectif, les événements touchés, le test réalisé et la procédure de retour arrière.
Conservez un dictionnaire des paramètres autorisés. Lorsqu’un nouveau champ apparaît, vérifiez sa finalité avant de le transmettre. Cette discipline réduit les données inutiles et facilite les audits. Elle aide aussi les équipes marketing, juridiques et techniques à parler du même flux plutôt que de multiplier les interprétations.
Éviter les erreurs fréquentes
La première erreur consiste à migrer des balises sans nettoyer le plan de marquage. La deuxième est d’envoyer simultanément les mêmes événements par les deux chemins. La troisième est de négliger la surveillance après le lancement. Enfin, certaines équipes présentent la solution comme un moyen de contourner les choix des utilisateurs, ce qui est une mauvaise base technique et éditoriale.
La documentation officielle de Google Developers sur l’introduction au taggage côté serveur décrit le rôle des clients, des événements et des conteneurs serveur. Elle constitue une source de référence pour vérifier l’architecture avant une mise en œuvre.
Décider si le moment est venu
Le taggage côté serveur devient pertinent lorsque l’organisation possède déjà un plan de mesure stable, des volumes suffisants, des besoins de contrôle précis et une capacité de maintenance. Une petite structure dont le marquage change chaque semaine doit d’abord stabiliser ses événements et sa gouvernance.
La bonne décision n’est donc pas « serveur ou navigateur » de manière absolue. Il s’agit de déterminer quel traitement doit rester côté client, quel contrôle mérite d’être centralisé et quelle complexité l’équipe peut réellement exploiter. Un pilote mesuré, réversible et documenté permet de répondre sans transformer l’architecture en pari coûteux.
Prévoyez enfin une revue après quelques semaines de fonctionnement. Comparez les bénéfices observés aux objectifs annoncés, corrigez les règles trop complexes et retirez ce qui n’apporte pas de contrôle supplémentaire. Une architecture simple et surveillée reste préférable à un dispositif sophistiqué dont personne ne comprend les dépendances.